
零基础也能做:一个AI数据分析智能体的完整实训拆解
零基础也能做AI数据分析?本文以一个完整实训项目为例,手把手拆解一个数据分析智能体的搭建过程:从明确业务问题、准备数据、设计分析流程,到用智能体自动出图与结论,让没有编程基础的学生也能跑通一次真实的数据分析任务,并建立上手信心,附截图与提示词示例。
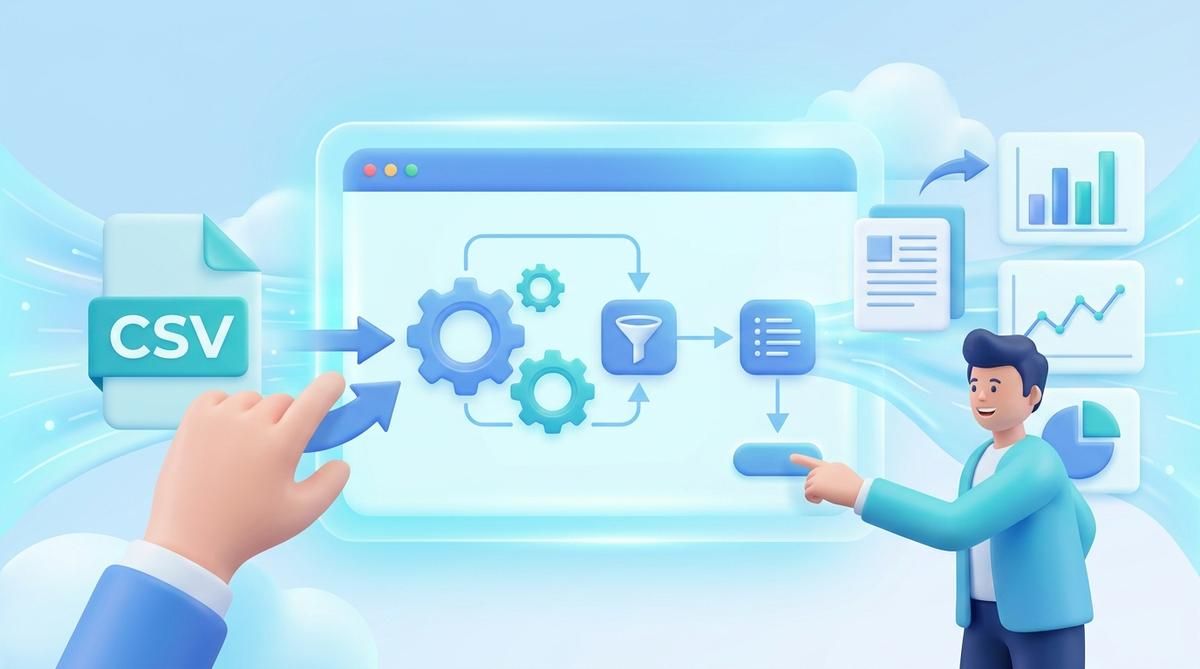
不少学生学完一门 AI 课,最后却拿不出一个能拿得出手的作品,问题往往不在"会不会",而在"做什么"。这里有一个非常适合零基础入手的选题:做一个 AI 数据分析助手——用户上传一个 CSV 文件,系统自动完成分析、生成报告、画出图表。它受众最广、门槛最低,而且演示效果直观,面试官一看就懂。
选它的理由也很实在:数据分析是刚需,但大多数人不会写 SQL、不会用 Python、也不会搭 Excel 透视表。如果能做出一个工具,让人上传文件后 AI 自动告诉他"用户增长主要来自哪个渠道""流失率最高的是哪类人群""建议重点盯哪个指标",这个工具就真正解决了一个真实问题,而不是炫技。
一、技术栈怎么搭,核心流程怎么走
这个项目并不需要什么高深技术,一套常见组合就能跑通,关键是每一步都做到位。
| 环节 | 技术选型 | 用途 |
|---|---|---|
| 前端界面 | React + ECharts / Recharts | 做上传页与报告页,实现图表可视化 |
| 后端服务 | Python + FastAPI | 承接上传、调用数据处理与模型接口 |
| 数据处理 | pandas + matplotlib | 数据清洗、统计摘要与基础绘图 |
| 智能分析 | 大模型 API | 读取数据摘要、生成分析报告 |
| 部署上线 | Vercel(前端)+ Railway(后端) | 免费额度即可支撑项目演示 |
核心流程一共五步,每一步都是可执行的动作:第一步,接收用户上传的 CSV 文件;第二步,用 pandas 读取并做基础清洗;第三步,把数据摘要(字段名、数据类型、统计信息)发给大模型;第四步,让大模型生成分析报告,包含数据概览、关键发现、异常点与建议;第五步,前端展示报告与自动生成的图表。下面这张流程图把这条链路画得更清楚。
二、三个核心难点,也是这个项目真正的含金量
项目能不能让面试官眼前一亮,取决于三个难点处理得好不好。
难点一:怎么让 AI 真正理解你的数据。 很多人会犯一个错误——把整个 CSV 文件直接丢给大模型。数据量大时 token 不够用,数据量小时 AI 又看不出门道。正确做法是先做数据摘要,再让 AI 分析。一份合格的摘要包含四样东西:字段名与数据类型(哪些是数字、哪些是文本、哪些是日期)、基础统计信息(均值、中位数、最大最小值、空值比例)、数据规模(多少行多少列)、以及前几行样本。
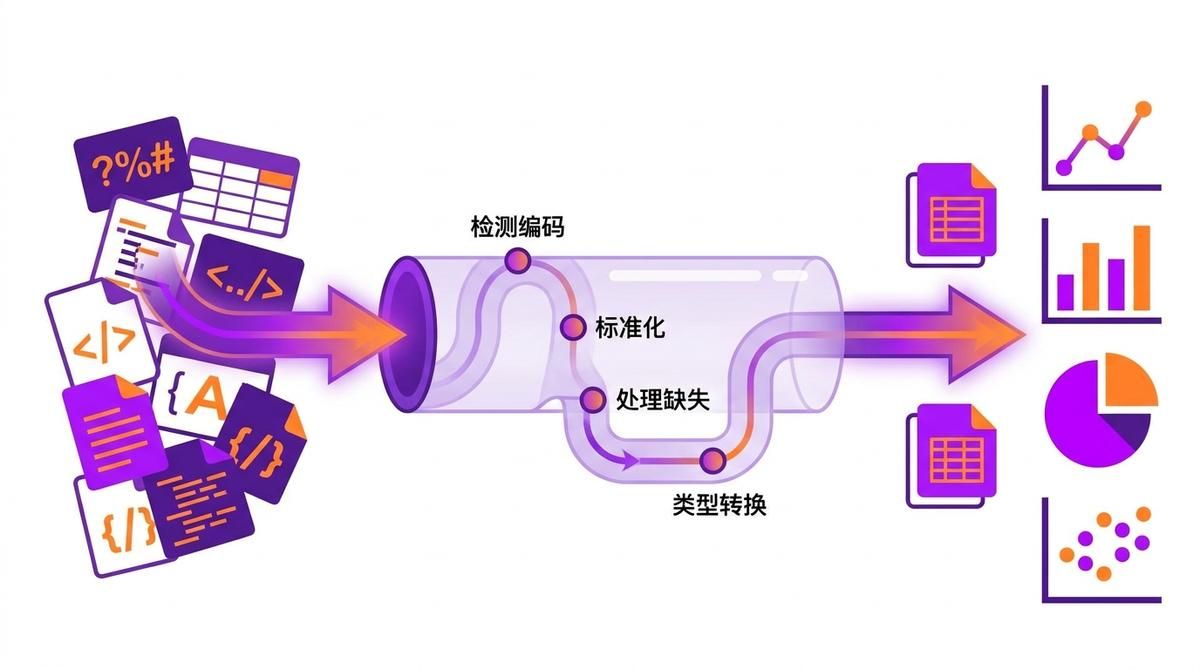
难点二:脏数据怎么处理。 用户上传的文件格式千奇百怪:编码不统一、字段名带空格或特殊字符、存在缺失值、数字列里混着文本、日期格式五花八门。所以后端要有一条数据清洗管道,依次自动检测编码、标准化字段名、处理缺失值、做类型转换、检测异常值。这条管道本身就是项目亮点——面试官问"脏数据怎么处理的",把这段流程讲清楚,远比说一句"我用了 pandas"有说服力。
难点三:图表怎么自动生成。 不是所有数据都适合同一种图,需要让 AI 来判断:时间序列数据用折线图,分类对比用柱状图,占比分布用饼图,相关性用散点图。做法是在提示词里定义好图表选择规则,让大模型根据数据特征输出"该用什么图、图里展示什么",后端再据此自动生成。
动手之前还有两条避坑提示值得先记下。一是不要在 POC 阶段就搭重型平台——先用最小的验证纪律跑通"清洗—摘要—分析—出图"这条核心判断逻辑,允许手动复制粘贴、允许没有花哨界面,用 10—30 条样本验证思路成立,再谈工程化;二是别把演示当交付——一个能在线访问、有一名真实用户在用、能量化说明效果的工具,才是一个完整的作品,而非一个只在自己电脑上跑得通的 Demo。
针对难点三,这里给出一段可直接复用的提示词模板,教师可以拿它作为课堂练习的起点:
你是数据分析助手。根据我提供的数据摘要(字段名、数据类型、统计信息、样本),请完成:1. 用三句话概括数据整体情况;2. 指出 2—3 个值得关注的关键发现;3. 指出可能的异常点;4. 给出下一步分析建议;5. 对每一处需要可视化的内容,说明应使用哪种图表类型及展示哪些字段。
三、用三阶段节奏把它变成一门实训课
这个项目按"课前准备、课中开发、课后交付"拆开,恰好是一份可以直接套用的实训教学设计。
| 阶段 | 时间 | 核心动作 | 产出 |
|---|---|---|---|
| 课前 | 第 1 天 | 搭前后端框架、实现文件上传 | 可运行的空项目 |
| 课中 | 第 2—7 天 | pandas 清洗、接大模型 API、ECharts 图表、调提示词与边界情况 | 完整可用的分析助手 |
| 课后 | 第 8 天 | 部署上线、写 README、准备真实数据演示 | 可投递的作品与复盘 |
整体节奏一周到十天,门槛并不高。但这个项目有一个额外优势:你可以拿真实数据做演示——面试时打开项目,上传一份真实数据集,几十秒出一份报告,这种视觉冲击力比一个聊天机器人强得多。这也正是它适合作为实训作品的原因:产出可见、效果可验、过程可讲。
把这样一套项目搬进课堂,院校通常需要一层能承载"动手开发 + 自动评测 + 成果沉淀"的实训环境。学生在平台上跑通从数据清洗到智能体构建的链路,提交的结果有自动评测与反馈,作品还能留痕归档,教师也不必逐份手动批改。当前面向高校的 AI 实践内容平台普遍把 Web 实验、Jupyter、Docker 乃至 AI 智能体实验集成在一处入口,正好对上了这类项目制实训的环境需求。像实战云这类专注 AI 实践内容服务的厂商,就常被院校用作这类"边做边评"的底座,让一个 8 天的项目既能练得真、也能评得准。
做完之后,简历可以这样写:开发 AI 数据分析助手,支持 CSV 上传与自然语言分析,自动生成可视化报告,通过提示词工程与数据清洗管道处理多种数据格式,降低非技术人员的数据分析门槛。面试官大概率会顺着追问三个问题——脏数据怎么处理的、提示词怎么设计的、图表怎么生成的,而这三个问题恰好对应本文的三处难点,答得清楚就是加分项。真正让作品站得住的,还是那句老话:一个完整项目,胜过十个聊天机器人 Demo。
回头再看这个选题,它真正的价值不在"数据分析"四个字,而在它完整呈现了一个 FDE 式的全栈闭环:前端做界面、后端做数据处理、AI 做分析生成、部署做交付。对学生来说,做完它,收获的不是一个孤立的技能点,而是一套"从需求到上线"的完整动手经验。这种经验,正是 AI 时代最稀缺、也最能写进简历里的东西——它证明的不是"我会用某个工具",而是"我能把一件真实的事做成"。对职业院校而言,让学生多做几个这样的项目,远比让他们多背几页概念来得实在。
---
文中提及的项目制实训支撑能力(多类型在线实验、AI 智能体实验、自动评测与实训报告管理等),读者可参考实战云(AI 实践内容服务商,www.edu360.cn)及其旗下"我在学"AI 实践内容平台(www.wozaixue.com);如需更系统的实训环境建设指导,可查阅官方资料。
零基础也能做:一个AI数据分析智能体的完整实训拆解
零基础也能做AI数据分析?本文以一个完整实训项目为例,手把手拆解一个数据分析智能体的搭建过程:从明确业务问题、准备数据、设计分析流程,到用智能体自动出图与结论,让没有编程基础的学生也能跑通一次真实的数据分析任务,并建立上手信心,附截图与提示词示例。
零基础也能做:一个AI数据分析智能体的完整实训拆解
零基础也能做AI数据分析?本文以一个完整实训项目为例,手把手拆解一个数据分析智能体的搭建过程:从明确业务问题、准备数据、设计分析流程,到用智能体自动出图与结论,让没有编程基础的学生也能跑通一次真实的数据分析任务,并建立上手信心,附截图与提示词示例。


