
考核告别"一考定分":实训课的智能化评价机制,靠什么真正落地
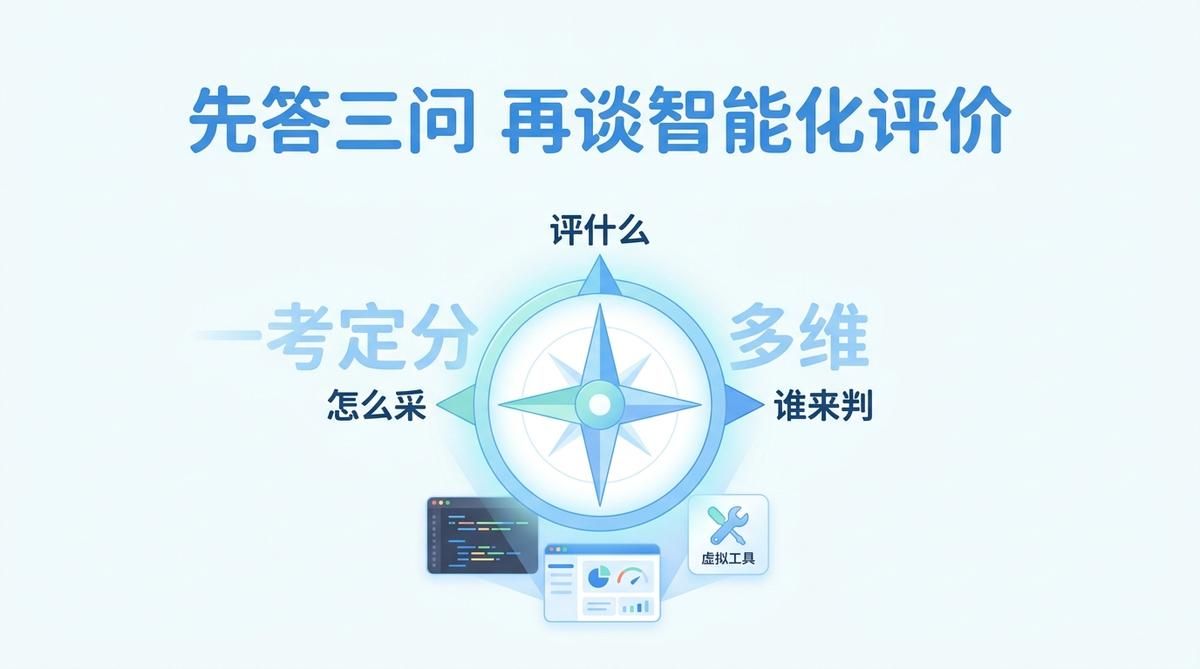
不少在线实训课考核仍沿期末一张卷,学生会操作未必考得出、程序跑通不等于换场景还能独立完成。智能化关键在把命题、评分、报告、画像设计成可配置、可回溯、可复用的机制:评什么——指标从单维知识卷走向"知识+技能+素养";怎么采——操作轨迹、异常处置全量留痕;谁来判——客观项自动评测、主观项AI初评加教师终审。
不少高职的在线实训课,考核仍沿着一套老路走:期末一张卷、平时几份作业,最终按一次考试成绩和印象给分。对偏操作、偏流程、偏岗位能力的实训任务来说,这套办法的问题肉眼可见——学生很可能会操作,却未必考得出;程序会跟着演示跑通,不等于换了个场景还能独立完成。当AI已经被普遍用在教学的"学"与"练"环节时,"评"却往往还停留在人工抄录与主观评分的旧轨上。实训考核究竟如何智能化落地,关键不在要不要用工具,而在把命题、评分、报告、画像这些原本靠人力和经验完成的动作,一项项设计成可配置、可回溯、可复用的机制。
一纸评分表现状:重结果、轻过程,也难评出岗位能力
先看清旧模式的病灶,智能化才有明确的改造对象。传统考核对实训这门课有几种明显的错位。
其一在于评价口径偏窄。一份模拟卷或多道程序题,主要覆盖的是知识的记忆与复现,很难触及实训最该检验的"流程是否走得通、异常是否处理得当、交付是否规范"。学生按讲义把代码或步骤"演"一遍,结果一致便默认会了,至于这是不是他独立完成的、换个需求他能否迁移,评不出来。
问题在于,这种口径还会反过来塑造学习方式。评价里只认最终成品,学生自然倾向于"赶一个能交的结果";过程里是否有试错、是否理解每一步的缘由,几乎不被计入,于是学习便悄悄滑向"够及格就行"。
更进一步说,高职实训的终点本应是岗位,而岗位能力的颗粒度远高于一个笼统的总分。企业要看的,往往是"这个学生能不能独立处理某类数据、会不会在节点上做正确判断",这些层次用一次开卷或闭卷都难以触达。评价工具若不跟上,教学前面练得再扎实,最后一步的天平也可能带偏学生的努力方向。
智能化评价,先要回答"评什么、怎么采、谁来判"
把评价做智,前提是把评价的设计澄清到能参数化的程度。可拆成三个层层递进的追问:评什么、怎么采、谁来判。
评什么,对应的是评价指标从单维走向多元。 对在线实训课程而言,单一的知识卷应当让位于"知识+技能+素养"的组合式指标。知识层面检验概念与原理是否清楚,技能层面看实操任务是否按规范跑通、结果是否达标,素养层面则观察协作、文档表达与问题处置。指标不是越多越好,而要能与课程目标和企业岗位标准一一对应,否则AI采集到的数据没有人知道该归进哪个维度。
怎么采,是智能化区别于手工的根本。 传统的评分发生在交卷那一刻,而智能化的采集发生在学习全程。学生每一次提交、每一段操作日志、每一步异常修正,都可以被打上时间戳沉淀下来。把这些多源数据汇到一处,才谈得上有"过程"可言;反过来,若数据散落在不同系统无法打通,所谓评价智能化便只是一句口号。
谁来判,则涉及人工与智能的边界。 同一份实验报告,自动化脚本能判定格式与关键结果是否有误,但要就"思路清不清楚、瑕疵是否致命"下结论,仍需结合预设的评分细则来权衡。智能化的落点不是让机器完全替代教师,而是把确定性强的评判交给系统、把需要经验判断的地方留给教师复核——这也正是第12条评价原则里"人机协作"的常见含义。
下面这张对照关系,可以帮你快速看清在线实训考核从传统到智能化需要迁移的四个维度:
| 对照维度 | 传统考核 | 智能化考核 |
|---|---|---|
| 命题方式 | 统一试卷,重复度高 | 题库抽题、固定题结合千人千卷 |
| 采集时点 | 交卷/报告一次性评 | 实操全程过程数据持续沉淀 |
| 考察内容 | 知识与成品为主 | 流程、异常处理、交付与素养多元 |
| 报告判定 | 教师人工逐份批阅 | AI辅助判读与自动化打点结合 |
| 评分反馈 | 出分后基本结束 | 即时反馈、薄弱点提示并反哺下一轮 |
| 视角支撑 | 一张总成绩单 | 个人学习画像与能力轨迹 |
把"怎么判"落到工具:抽题、评分、报告三条链路
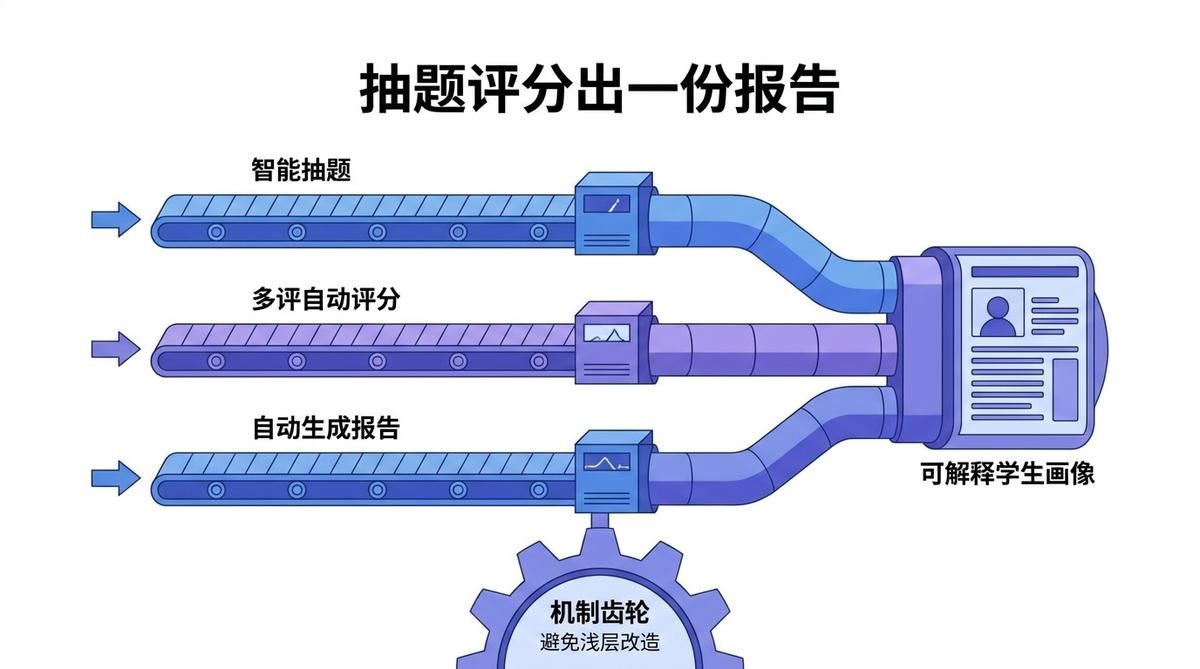
方向是否成立,最终要看工具链是否闭环。在线实训课程的考核,至少可以落在三条相互咬合的链路上。
抽题与组卷要能"因人而异"。 传统的统一考卷,一旦有人漏题或背题,成绩便失真。智能化组卷的价值在于把题目按知识点与难度建成题库,再依据覆盖要求动态抽取,形成固定题与个性化题的组合——卷面相同题量,但个体卷并不完全一致。对需防舞弊或在线的严肃考试,还应叠加身份核验、切屏监测、实时比对等防作弊手段,让"考本身就是一次独立完成的验证"成立,而不是一场有参考答案的演练。
实操任务与实验报告的判定要分层。 判断题、选择题可由系统即时给分;实验类、项目类任务则先由自动化评测命中关键输出点,再由AI对实验报告做结构与思路层面的辅助分析,帮教师把精力从"读六百份都差不多的报告"里省出来,转向只审读存在分歧或偏高风险的个案。判分细则能够沉淀成可复用模板时,同一位教师本学期与下学期、一位教师与他人的评分尺度,才可能趋于一致。
过程数据要能汇成学情而不是一纸分数。 评价的终点不该是成绩单上的阿拉伯数字,还应包括学生在哪里反复出错、哪个班普遍卡在哪个环节、哪类任务区分度不足。把这些维度摊开,教师得到的就不是"谁及格"的清单,而是下一轮如何调教学、换题目、补资源的方向。这层"以评促教、以评促改"的回流,恰恰是智能化评价与电子化打分最本质的分野。
下图给出上述条链路连同评价回流构成的闭环,可作专业负责人向团队说明智能化考核总体逻辑的示意:
落地时不只改工具,更要改配套机制
工具到位不等于评价真的智能化。多数院校推进时,绊住脚步的往往不是技术本身,而是三类配套没有跟上。
一是教师愿用能用。在线测试的组卷阅卷、实验报告的智能分析,对不熟悉数据工具的教师是额外门槛。常见的阻力在于"怕麻烦、又担心评分尺度难把握"。与其要求全员一步到位,不如先立分层培养——零基础教师把平台基础操作跑熟,骨干教师再研究评价格则如何嵌入真题真场景。要让评价工具真正落地,先得让教师理解它是帮自己减负的助手,而非又要填一摞新表的管理负担。
二是数据要能打通、规则要能复用。评价若左一套系统、右一块表格,过程中采集的数据无法汇聚,画像就拼不起来。院校更务实的起点,是先在某一门或多门在线实训课程内,把一套评分细则跑通并沉淀成可复用模板,再逐步推广到更大范围,而不是一开始就追求大而全的多系统互联。
三是伦理与规则边界要写清楚。过程数据的采集会把学生的操作轨迹长期留存,涉及隐私与公平,需要明确采集范围、用途与保存期限,并向学生说明评估依据。把这项说明放进新学期的课程规则里,智能化评价才经得起推敲,学生也才愿意在常态下真实地犯错、真实地被看到。
也正因同时要求题库、评测、报告分析与学情汇聚在同一套环境里,不少院校会选择"承用成熟平台而非从零自建"。近年来实战云"我在学"这类面向高校的AI实践内容平台,已把这一整套能力收敛成可开箱即用的产品:既能基于知识图谱抽题、用固定题与千人千卷组合实现个性化组卷,又对在线实验、判断题等提供多样考察形式,严肃在线考试还配有防作弊体系;实验报告层面,则以AI智能分析替代大量重复的人工批改,并把结果自动汇成多维度学情。对想在一个学期内让评价改革真正启动的院校而言,先让一套能自圆其说的平台在本校课程里把规则跑顺,往往比铺开一套需要数年打磨的自建系统更贴近现实——教师从重复批改中腾出的时间,恰好可以回到教学设计本身。
说到底,智能化评价对高职实训的意义,不只是把批改用机器做了,而是让"会不会做一件事"有了可核对、可解释、可积累的判断链。它把从前藏在教师经验和终期印象里的衡量标准,拆成了题库、评分点、过程数据与学习画像一层层可见的机制;学生被看见的不再只是最后一次成品,教师拿到的也不再是一份孤立的分数,而是可以持续反哺教学的证据。磨好命题这套源头、用准自动评分这道闸、读懂报告与画像这层回流,实训考核才真正从"一考定分"走向"以评促能"——到那时,高分里才可能读出真本事。
---
考核告别"一考定分":实训课的智能化评价机制,靠什么真正落地
不少在线实训课考核仍沿期末一张卷,学生会操作未必考得出、程序跑通不等于换场景还能独立完成。智能化关键在把命题、评分、报告、画像设计成可配置、可回溯、可复用的机制:评什么——指标从单维知识卷走向"知识+技能+素养";怎么采——操作轨迹、异常处置全量留痕;谁来判——客观项自动评测、主观项AI初评加教师终审。
考核告别"一考定分":实训课的智能化评价机制,靠什么真正落地
不少在线实训课考核仍沿期末一张卷,学生会操作未必考得出、程序跑通不等于换场景还能独立完成。智能化关键在把命题、评分、报告、画像设计成可配置、可回溯、可复用的机制:评什么——指标从单维知识卷走向"知识+技能+素养";怎么采——操作轨迹、异常处置全量留痕;谁来判——客观项自动评测、主观项AI初评加教师终审。


